3. OLAP und Data Warehousing
OLAP und Data Warehousing
Abschnitt betitelt „OLAP und Data Warehousing“Datenteams in Unternehmen arbeiten mit sehr unterschiedlichen Daten und brauchen deshalb unterschiedliche Systeme. Zwei der wichtigsten sind:
- OLTP – Online Transaction Processing
- OLAP – Online Analytical Processing
Einfach gesagt unterstützen OLTP-Systeme die tägliche Arbeit eines Betriebs: viele kleine Aktionen wie ein Einkauf im Shop, eine geänderte Adresse oder ein neues Passwort. OLAP-Systeme dienen dagegen der Analyse: Sie beantworten Fragen wie „Wie viele Produkte wurden letzten Monat verkauft?”, „Welches Produkt verkauft sich am besten?” oder „Wie haben sich die Umsätze über die Jahre entwickelt?”.
OLTP – Online Transaction Processing
Abschnitt betitelt „OLTP – Online Transaction Processing“Ein OLTP-System arbeitet mit Transaktionen: kleine, klar umrissene Aktionen, die Daten ändern und korrekt gespeichert werden müssen. Typische Beispiele sind ein Kassenverkauf, eine Bestellung im Onlineshop, ein reduzierter Lagerbestand oder ein aktualisiertes Profil.
All diese Aktionen sind kurz, haben einen klaren Anfang und ein klares Ende und müssen schnell und zuverlässig verarbeitet werden. Geht dabei etwas schief, wird die ganze Operation zurückgerollt, damit die Daten konsistent bleiben.
Weil OLTP-Systeme stark strukturierte Daten in Tabellen speichern, nutzen sie meist relationale Datenbanken wie PostgreSQL, MySQL oder SQL Server. Technisch sind sie auf Geschwindigkeit, Zuverlässigkeit und viele gleichzeitige Nutzer ausgelegt. Niemand will an der Kasse warten, und niemand will ein Online-Banking, das eine Überweisung „vergisst”.
Merkmale von OLTP-Systemen
Abschnitt betitelt „Merkmale von OLTP-Systemen“- Hohe Nebenläufigkeit: Viele Nutzer arbeiten gleichzeitig, etwa alle Filialen eines Handelskonzerns zur selben Zeit. Alle Transaktionen müssen korrekt gespeichert werden, ohne sich zu stören.
- Echtzeit: Eine Änderung wird sofort sichtbar. Wird die letzte Konsole gekauft, steht sie danach sofort auf „ausverkauft”.
- Kurze Transaktionen: Die meisten Operationen betreffen nur wenige Zeilen und sind in Millisekunden fertig.
- Schnelle Antwortzeiten: Weil diese Operationen so häufig sind, wird auf kurze Reaktionszeiten optimiert.
Typische OLTP-Systeme sind Kassensysteme (Point of Sale), Online-Banking und CRM-Software. Sie erledigen das Tagesgeschäft: verkaufen, buchen, aktualisieren, ändern.
OLAP – Online Analytical Processing
Abschnitt betitelt „OLAP – Online Analytical Processing“Während OLTP den operativen Alltag bedient, geht es bei OLAP um Analyse und das Verstehen dessen, was im Betrieb passiert. OLAP-Systeme finden Muster, erkennen Trends und stützen strategische Entscheidungen.
Sie arbeiten mit großen Datenmengen über lange Zeiträume, oft Monate oder Jahre. Statt einen einzelnen Beleg zu betrachten, schauen sie alle Belege zusammen an und beantworten Fragen wie „Welche Regionen laufen am besten?” oder „Welche Produkte verlieren an Beliebtheit?”.
Wie OLAP auf Daten blickt
Abschnitt betitelt „Wie OLAP auf Daten blickt“OLAP ordnet Daten oft auf besondere Weise. Historisch beschrieb man das als OLAP-Cube (Würfel). Die Grundidee: Daten aus vielen Blickwinkeln, den Dimensionen, betrachten.
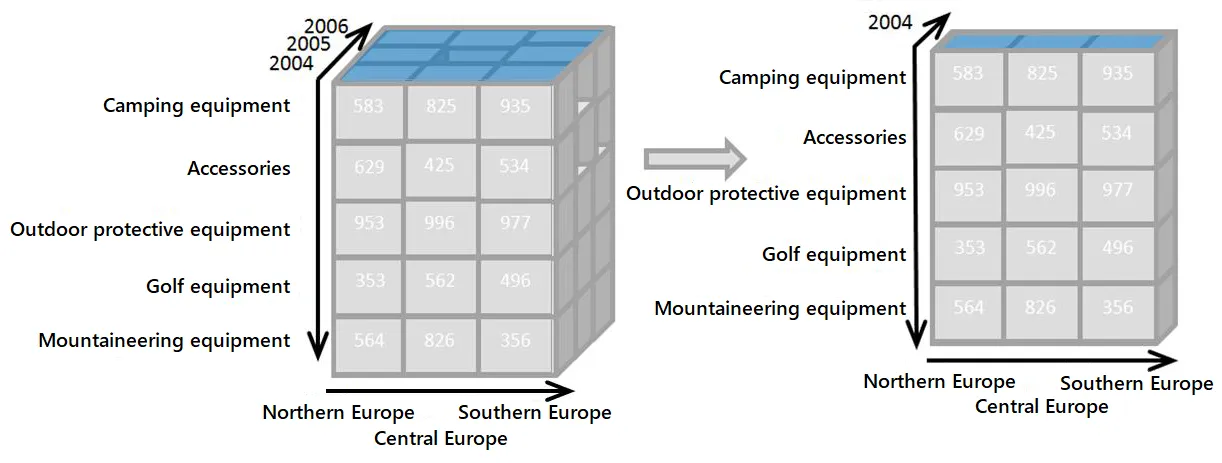
Man kann sich einen OLAP-Würfel wie einen dreidimensionalen Würfel vorstellen, nur mit mehr möglichen Dimensionen. Eine Achse ist die Zeit (Tag, Monat, Jahr), eine andere das Produkt, eine dritte die Region. Aus dieser Struktur lässt sich eine „Scheibe” herausschneiden, etwa alle Verkäufe von Produkt A in Kärnten im Jahr 2024, oder der Vergleich 2023 gegen 2024 über alle Produkte.
Operationen auf dem Würfel
Abschnitt betitelt „Operationen auf dem Würfel“Das Erkunden eines OLAP-Würfels folgt einigen wiederkehrenden Grundoperationen. Sie haben eigene Namen, die man kennen sollte, weil sie in jedem BI-Werkzeug auftauchen. Alle lassen sich in SQL letztlich mit WHERE, GROUP BY und dem Wechsel der Detailebene ausdrücken.
Slicing („eine Scheibe herausschneiden”) schneidet aus dem Würfel eine flache Scheibe, indem eine Dimension auf einen Wert festgelegt wird. Der Würfel verliert dadurch eine Dimension. Beispiel: „nur das Jahr 2024” — übrig bleibt eine zweidimensionale Fläche aus Produkt und Region über alle übrigen Werte. In SQL ist das eine einzelne Bedingung:
-- Slicing: die Zeit-Dimension auf 2024 festlegenSELECT produkt, region, SUM(umsatz)FROM verkaeufeWHERE jahr = 2024GROUP BY produkt, region;Dicing („einen kleineren Würfel herausschneiden”) schränkt mehrere Dimensionen auf jeweils einen Bereich oder eine Auswahl ein. Anders als beim Slicing bleibt das Ergebnis ein Würfel, nur kleiner. Beispiel: „Produkt A oder B, in Kärnten oder Tirol, in den Jahren 2023 und 2024”. In SQL sind das mehrere Bedingungen zugleich:
-- Dicing: mehrere Dimensionen gleichzeitig einschränkenSELECT jahr, produkt, region, SUM(umsatz)FROM verkaeufeWHERE produkt IN ('A', 'B') AND region IN ('Kärnten', 'Tirol') AND jahr IN (2023, 2024)GROUP BY jahr, produkt, region;Drill-down und Roll-up wechseln die Detailebene einer Dimension. Beim Drill-down geht man ins Feinere (von Jahr auf Monat auf Tag, von Region auf Bundesland auf Ort), beim Roll-up fasst man zum Gröberen zusammen (von Monat zurück auf Jahr). In SQL bedeutet das, in einer hierarchischen Dimension eine andere Ebene zu gruppieren.
Merkmale von OLAP-Systemen
Abschnitt betitelt „Merkmale von OLAP-Systemen“- Komplexe Analysen statt kleiner Transaktionen: wenige, aber sehr schwere Leseabfragen, die Millionen Zeilen scannen.
- Multidimensionale Struktur: Daten sind um Dimensionen wie Zeit, Region, Produkt oder Kundengruppe organisiert.
- Historische Auswertung: Zeit ist eine zentrale Dimension, um Perioden zu vergleichen und saisonale Muster zu erkennen.
Weil OLAP das Erkunden von Daten so erleichtert, ist es ein Kernbaustein der Business Intelligence: Es speist Dashboards mit Kennzahlen (KPIs) und Berichte für das Management.
Das Data Warehouse
Abschnitt betitelt „Das Data Warehouse“Ein zentrales Element ist das Data Warehouse (DWH): eine große, zentrale Datenbank, die Daten aus vielen Quellen sammelt und über lange Zeit für Analysen aufbewahrt. Man kann es sich als das Langzeitgedächtnis eines Betriebs vorstellen.
Als durchgehendes Beispiel dient die fiktive Streaming-Plattform StreamHub. Sie will wissen, welche Videos wie lange geschaut werden, welche Geräte die Zuschauer nutzen und wie viel Werbung einbringt.
Woher die Daten kommen
Abschnitt betitelt „Woher die Daten kommen“Die Rohdaten liegen zunächst in mehreren operativen Systemen (OLTP), jedes für seine Aufgabe optimiert:
- die Streaming-App protokolliert jeden Wiedergabestart und die geschaute Dauer,
- der Werbeserver hält fest, welche Anzeige gezeigt wurde und was sie einbrachte,
- das CMS verwaltet die Videos selbst (Titel, Genre, Länge, Auflösung),
- der Abrechnungsdienst kennt die Abomodelle der Nutzer.
Ein regelmäßiger Ladeprozess (ETL – Extract, Transform, Load) holt diese Daten heraus, vereinheitlicht sie und schreibt sie ins DWH. Die Integration über Systemgrenzen hinweg wird in Kapitel 6 vertieft.
Vier Eigenschaften eines Data Warehouse
Abschnitt betitelt „Vier Eigenschaften eines Data Warehouse“Ein DWH unterscheidet sich grundlegend von einer operativen Datenbank. Klassisch beschreibt man es über vier Eigenschaften:
- Themenorientiert: Es ist um Analysethemen organisiert (Wiedergaben, Werbeeinnahmen), nicht um einzelne Anwendungen.
- Integriert: Daten aus vielen Quellen werden vereinheitlicht. Nennt die App ein Gerät „iPhone” und der Werbeserver „Apple iOS”, wird beim Laden ein einheitlicher Wert daraus.
- Zeitbezogen: Das DWH hält die Historie über Jahre. Jede Zeile trägt einen Zeitbezug, damit man Perioden vergleichen kann.
- Beständig: Einmal geladene Daten werden nicht mehr geändert oder gelöscht, nur ergänzt. Man überschreibt keine alten Zahlen, sonst wäre die Historie verfälscht.
Der Kontrast zum OLTP-Schema ist grundlegend: Ein OLTP-System ist stark normalisiert, um Redundanz zu vermeiden und Schreibvorgänge sicher zu machen. Ein DWH wird bewusst denormalisiert, damit Analysen mit wenigen Joins schnell und einfach bleiben.
Stern- und Schneeflockenschema
Abschnitt betitelt „Stern- und Schneeflockenschema“Fakten und Dimensionen
Abschnitt betitelt „Fakten und Dimensionen“Ein DWH trennt zwei Arten von Daten:
- Die Faktentabelle enthält die messbaren Kennzahlen (Measures), die man summieren oder mitteln will. Bei StreamHub sind das die Aufrufe, die Wiedergabezeit in Minuten und die Werbeeinnahmen. Dazu kommen Fremdschlüssel auf jede Dimension.
- Die Dimensionstabellen liefern den beschreibenden Kontext, also das „Wer, Was, Wann, Womit”: welches Video, welcher Tag, welches Gerät, welches Zuschauersegment.
Sternschema am Beispiel StreamHub
Abschnitt betitelt „Sternschema am Beispiel StreamHub“Im Sternschema (Star Schema) steht die Faktentabelle in der Mitte, die Dimensionen liegen wie Strahlen darum herum:
flowchart TB
  DZ["Dim_Zeit<br/>datum, wochentag, monat, jahr"] --> F
  DV["Dim_Video<br/>titel, genre, laenge_min, aufloesung"] --> F
  F["Fakt_Wiedergabe<br/>aufrufe, wiedergabe_min, werbeeinnahmen"]
  DG["Dim_Geraet<br/>geraetetyp, betriebssystem"] --> F
  DP["Dim_Zuschauer<br/>altersgruppe, abo_typ, region"] --> F
Die Tabellen sehen etwa so aus:
Fakt_Wiedergabe (eine Zeile je Video, Tag, Gerät und Zuschauersegment)
| zeit_id | video_id | geraet_id | zuschauer_id | aufrufe | wiedergabe_min | werbeeinnahmen |
|---|---|---|---|---|---|---|
| 20240115 | 501 | 3 | 12 | 1840 | 22050 | 148.20 |
| 20240115 | 502 | 1 | 7 | 640 | 5120 | 41.90 |
Dim_Video
| video_id | titel | genre | laenge_min | aufloesung |
|---|---|---|---|---|
| 501 | Kärnten von oben | Dokumentation | 44 | 4K |
| 502 | Basketball-Finale | Sport | 96 | 1080p |
Dim_Geraet
| geraet_id | geraetetyp | betriebssystem |
|---|---|---|
| 1 | Smart-TV | Tizen |
| 3 | Smartphone | Android |
Die Kennzahlen der Faktentabelle sind bewusst additiv gewählt: Man kann sie über beliebige Dimensionen aufsummieren, und das Ergebnis bleibt sinnvoll. Addiert man die wiedergabe_min aller Zeilen eines Genres, erhält man die gesamte Wiedergabezeit dieses Genres; summiert man über Tage, Geräte oder Zuschauersegmente, passt es genauso.
Deshalb speichert man in der Faktentabelle die rohen, summierbaren Grundgrößen (Minuten, Aufrufe, Euro) und keine abgeleiteten Werte wie Durchschnitte oder Prozentsätze. Zwei Durchschnitte darf man nämlich nicht einfach addieren: Aus „im Schnitt 12 Minuten” und „im Schnitt 8 Minuten” wird nicht „20 Minuten”. Einen Durchschnitt rechnet man erst bei der Abfrage aus den Grundgrößen aus, etwa als SUM(wiedergabe_min) / SUM(aufrufe).
Eine typische Auswertung verbindet die Faktentabelle per Join mit den benötigten Dimensionen und gruppiert nach ihren beschreibenden Spalten. Zum Beispiel die Wiedergabezeit je Genre und Monat:
SELECT z.jahr, z.monat, v.genre, SUM(f.wiedergabe_min) AS minutenFROM fakt_wiedergabe fJOIN dim_zeit z ON f.zeit_id = z.zeit_idJOIN dim_video v ON f.video_id = v.video_idGROUP BY z.jahr, z.monat, v.genreORDER BY minuten DESC;Oder die Werbeeinnahmen je Gerätetyp und Abomodell:
SELECT g.geraetetyp, p.abo_typ, SUM(f.werbeeinnahmen) AS einnahmenFROM fakt_wiedergabe fJOIN dim_geraet g ON f.geraet_id = g.geraet_idJOIN dim_zuschauer p ON f.zuschauer_id = p.zuschauer_idGROUP BY g.geraetetyp, p.abo_typORDER BY einnahmen DESC;Der Name „Stern” kommt von der Form: eine Faktentabelle in der Mitte, Dimensionen als Strahlen. Weil die Dimensionen denormalisiert sind (das Genre steht direkt in dim_video, nicht in einer eigenen Tabelle), braucht jede Abfrage nur wenige Joins und bleibt schnell und lesbar.
Schneeflockenschema
Abschnitt betitelt „Schneeflockenschema“Das Schneeflockenschema (Snowflake Schema) ist eine Variante, bei der die Dimensionen zusätzlich normalisiert werden. Aus dim_video wird zum Beispiel das Genre in eine eigene Tabelle dim_genre ausgelagert, und die Region der Zuschauer wird zu dim_region und dim_land aufgeteilt:
flowchart TB
  DG["Dim_Genre<br/>genre_id, name"] --> DV
  DV["Dim_Video<br/>titel, genre_id, laenge_min"] --> F
  F["Fakt_Wiedergabe<br/>aufrufe, wiedergabe_min"]
  DP["Dim_Zuschauer<br/>altersgruppe, abo_typ, region_id"] --> F
  DR["Dim_Region<br/>region_id, name, land_id"] --> DP
  DL["Dim_Land<br/>land_id, name"] --> DR
Die verzweigten Dimensionen erinnern an eine Schneeflocke. Eine Auswertung je Genre braucht jetzt einen zusätzlichen Join:
SELECT ge.name AS genre, SUM(f.wiedergabe_min) AS minutenFROM fakt_wiedergabe fJOIN dim_video v ON f.video_id = v.video_idJOIN dim_genre ge ON v.genre_id = ge.genre_idGROUP BY ge.nameORDER BY minuten DESC;Der Vorteil: Der Text „Dokumentation” steht nur einmal in dim_genre statt tausendfach in dim_video; das spart Speicher und hält die Bezeichnungen konsistent. Der Nachteil: mehr Tabellen, mehr Joins, komplexere Abfragen.
| Sternschema | Schneeflockenschema | |
|---|---|---|
| Dimensionen | denormalisiert (flach) | normalisiert (verzweigt) |
| Joins je Abfrage | wenige | mehr |
| Speicherbedarf | etwas höher | geringer |
| Lesbarkeit & Tempo | hoch | niedriger |
Zusammenfassung
Abschnitt betitelt „Zusammenfassung“- OLTP bedient das Tagesgeschäft: viele kleine, schnelle, zuverlässige Änderungen mit hoher Nebenläufigkeit.
- OLAP dient der Analyse: multidimensionale Sicht auf große, meist historische Datenmengen.
- Ein Data Warehouse sammelt per ETL Daten aus vielen Quellen; es ist themenorientiert, integriert, zeitbezogen und beständig und wird bewusst denormalisiert.
- Die Faktentabelle enthält die summierbaren Kennzahlen, die Dimensionstabellen den beschreibenden Kontext; die Körnung legt fest, was eine Faktenzeile bedeutet.
- Das Sternschema (flache Dimensionen, wenige Joins) ist das gängige Modell; das Schneeflockenschema normalisiert die Dimensionen, spart Speicher, erhöht aber die Komplexität.
- Den OLAP-Würfel erkundet man mit Slicing (eine Dimension festlegen), Dicing (mehrere Dimensionen einschränken), Drill-down (mehr Detail) und Roll-up (mehr Zusammenfassung).
- Kurz: OLTP hilft, den Betrieb zu führen, OLAP hilft, ihn zu verstehen und zu verbessern.